概率与统计第 1 章
Sampling and Data
本章目录
这一章给你一套词汇和判断力,让你能批判地阅读任何基于样本的说法:这组关系本身、一个样本如何即使很大也会出问题,以及怎么分辨普通的随机变异和真正的问题。章末再加两个此后每一组数据都用得上的区分:,然后在定量数据之内,再分。
为什么研究样本,而不是每一个人
总体(population)是你想了解的整个群体;样本(sample)是你实际考察的那一部分。
先问这个问题真正关心的是哪一个群体,那就是总体;再看你测量了其中多少。测量全部的情况很少见:通常太慢、太贵,有时还具有破坏性,比如工厂把灯泡测试至失效。
一所大学有 40,000 名学生,想知道学生对食堂有多满意(假设的例子)。调查全部 40,000 人会很准确,但既慢又贵,所以改为调查 300 人:总体是全部 40,000 名学生;样本是被问到的那 300 人。
“总体越大,样本就要按比例越大,所以 1% 的样本只有在总体很小的时候才够用。” 样本量不必随总体容量按比例增大:全国性民调靠大约 1,000 至 2,000 人的样本,就能描述人数以亿计的总体,因为样本是怎么选出来的,远比它占总体多大比例重要。“样本基本上就是总体的缩影,所以样本里成立的事,在总体里也一定成立。” 样本是关于总体的证据,不是总体的缩影;后面几节会讲这些证据怎么误导人。
参数描述总体,统计量描述样本
参数(parameter)是描述总体的一个数;统计量(statistic)是描述样本、并用来估计参数的一个数。
问这个数是从什么算出来的。从整个算出来的是参数,实际上总体往往无从得知,参数常写作 。只从你实际收集到的样本算出来的是统计量,写作 。设总体容量为 ,样本量为 :参数是固定的,通常未知;统计量是已知的,但只是参数的一个估计。
一所学校有 4,000 名学生(),它的真实平均 GPA(平均绩点)没有人知道。你调查了 50 名学生(),算出 。这个 3.1 是真实的,也算得正确,但它描述的是你那 50 名学生,不是全部 4,000 人。
“样本平均数就等于总体平均数,抽样的意义就在这里。” 不是: 是 的估计,由你手上真正有的数据算出来,代替一个你没有的数。“参数和统计量只是同一样东西的两个叫法。” 两者按定义就是不同的东西:把一项民调的统计量当成总体的参数、不带任何不确定性,是各种研究最常被误读的方式之一。
建立一个不会骗你的样本
当收集样本的方法让中某些成员比其他成员更容易或更不容易被选入,这个样本就有抽样偏差(sampling bias),无论多大也不能代表总体。
问这个方法是否给总体中每一个成员一个已知的、公平的机会,而不是问研究者有没有亲手挑人。简单随机样本(simple random sample)直接做到这一点;几种标准的变化做法不同,但同样公平。只找最容易找到的人,或者让人自行决定参与,都不合格。
一家商店在某个下午访问当时正在店内闲逛的顾客来测量满意度(假设的例子),这是方便样本(convenience sample)。方法本身就把当时不在店内的所有人排除在外,这种偏差叫覆盖不足(undercoverage)。
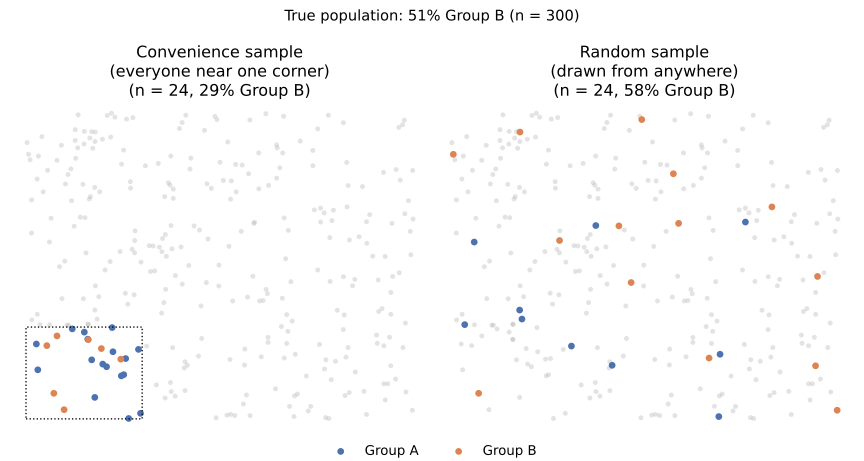
“随机抽样就是随手找身边或容易接触到的人。” 那是方便,不是随机:随机的方法给每个成员一个已知的机会,随手抓人永远做不到。“只要回应的人够多,样本无论怎么选都没问题,大样本不会有偏差。” 用同一个有缺陷的方法收集更多回应,只是把缺陷重复更多次,下面的案例正是这样。“让人自己决定要不要回应,是最公平、最没有偏差的建立样本方式。” 这叫自愿回应(voluntary response):意见强烈的人回应的比率远高于其他人。
1936 年,一本很受欢迎的美国杂志《文学文摘》(Literary Digest)就总统选举寄出大约一千万份问卷,收回约 240 万份,样本比今天任何民调所用的都大得多。它预测挑战者会轻松获胜;结果在任者以压倒性优势获胜。杂志的邮寄名单来自它自己的订户、汽车登记记录和电话簿,而在 1936 年,这些名单偏向较富裕、较少受大萧条冲击的家庭;收到问卷的人只有约四分之一回复,在覆盖不足之上又加了一层自愿回应。几百万份回复救不了一个有缺陷的方法。
同一个总体,不同的样本,不同的数字
抽样变异性(sampling variability)是从同一个总体抽出的不同随机样本所算出的之间自然存在的差异:这是意料之中的随机变异,不是。
两个同样大小、老老实实随机抽出的样本,几乎不会产生一模一样的统计量,而且两个都没有“错”。要问的是它们为什么不同:碰巧抽到不同的人,是变异性;方法偏袒某些人,就是了。
回到那个例子:4,000 名学生的学校。你随机调查 50 名学生,得到平均 GPA 3.1;一位同学另外随机调查 50 名,得到 3.4。你们两个都没有做错,只是没有调查同一批人。
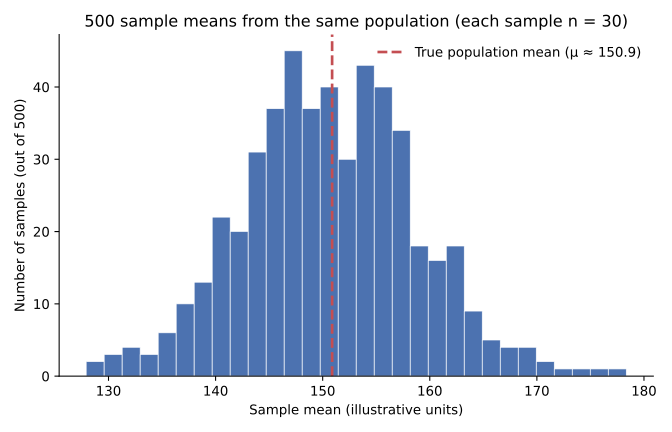
“如果我用一个新样本再做一次调查,应该得到跟之前一样的数字;结果不同,就是有地方出错了。” 没有出错:公平的方法每一次抽出的结果仍然会不同,因为它碰巧抽到谁是随机的,随机就是这个意思。“抽样变异性和抽样偏差基本上是同一个问题,都只是说样本不可信。” 不是:偏差来自样本是怎么选出来的;变异性来自公平的方法碰巧选中了哪些成员,而且即使消除了偏差,变异性仍然存在。
分类还是定量:这是哪一种数据
分类数据(categorical data,又叫定性数据 qualitative data)把每个个体归入一个组别或贴上一个标签;定量数据(quantitative data)是计数或测量的结果,对它做算术是有意义的。
别管一个值是用数字还是文字写的。问把两个值相加或取平均,得出的答案有没有任何意义。有,就是定量数据。没有,就是分类数据。
班级花名册上记录一名学生的发色是“棕色”,学号是“10583”。发色是分类数据。学号虽然全是数字,也是分类数据:把两个学号取平均,或者说一个学号“大于”另一个,都没有意义,它只是一个披着数字外衣的标签。
“写成数字的就是定量数据,写成文字的就是分类数据。” 邮政编码、电话号码和球衣号码全是数字,按上面的算术检验,仍然是分类数据。“分类数据不能真正用数字分析,只能用文字描述。” 你可以数出每个类别各有多少个体,再比较这些计数或比例;不能做的是把类别本身取平均,因为“棕色”加“金色”除以二,并不是一种发色。
计数还是测量:离散数据与连续数据
离散数据(discrete data)来自计数,只取一个个分开、可以逐一列出的值,值与值之间有真正的空隙;连续数据(continuous data)来自测量,可以落在一个尺度上的任何位置。
问在两个相邻的数据点之间,原则上有没有可能出现一个严格介于其间的值。有,就是连续数据。没有,就是离散数据。有没有小数不是判断标准:离散的计数取平均后可以是小数,连续的测量也可以正好落在整数上。
假设有一个 30 名学生的班级,兄弟姐妹的人数和以厘米计的身高都是。兄弟姐妹的人数来自计数:2 和 3 之间没有任何有效的值,所以是离散数据。身高来自测量:一个值可以落在 162 至 163 厘米之间的任何位置,所以是连续数据。
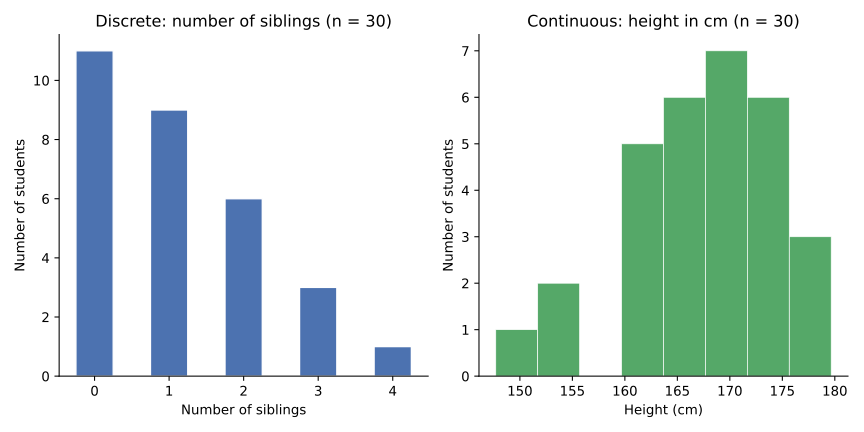
“数字有小数,数据就是连续的;是整数,就是离散的。” 离散的计数取平均后可以是小数:“平均每名学生有 1.8 个兄弟姐妹”很正常,虽然没有任何一名学生有 1.8 个兄弟姐妹;小数属于平均数,不属于任何一个单独的计数。“连续只是说数据里有很多不同的值。” 连续的测量也可以碰巧正好落在整数上,比如一名学生的身高正好是 170.0 厘米;重要的是中间的值有没有可能出现。
把各部分拼起来综合运用
最后一个假设的例子:一所大学想知道学生更喜欢线上课程还是线下课程。这又是的区分:全体学生,对比你实际收集到的那些人。
站在校园广场上逢人便问,是一种叫覆盖不足的问题:那个时候不在那里的学生没有机会被问到。把问卷放到网上、来者不拒,则有相反的偏差,就是自愿回应,让强烈的意见占比过高。你想要的是更接近简单随机样本的做法,给每一名学生一个已知的、公平的机会。
无论你得到什么样本,样本中偏好线上课程的比例是一个统计量:它是你对真实的最佳证据,而参数是全校学生的实际比例,永远无法准确知道。同学做一个同样有效的调查,得到一个稍有不同的数字,那是平常的,不是错误。
顺带一提:学生的偏好是;上过多少门线上课程是定量而离散的数据;每周通勤的小时数是定量而的数据。这六个概念没有一个是可有可无的:每一个都是一个信心十足的数字误导你的方式,只要你不先问它是哪一种数字。