概率與統計第 1 章
Sampling and Data
本章目錄
這一章給你一套詞彙和判斷力,讓你能批判地閱讀任何建基於樣本的說法:這組關係本身、一個樣本如何即使很大也會出問題,以及怎樣分辨普通的隨機變異和真正的問題。章末再加兩個此後每一組數據都用得上的區分:,然後在定量數據之內,再分。
為什麼研究樣本,而不是每一個人
總體(population)是你想了解的整個群體;樣本(sample)是你實際檢視的那一部分。
先問這個問題真正關心的是哪一個群體,那就是總體;再看你量度了其中多少。量度全部的情況很少見:通常太慢、太貴,有時還具破壞性,例如工廠把燈泡測試至失效。
一所大學有 40,000 名學生,想知道學生對飯堂有多滿意(假設的例子)。訪問全部 40,000 人會很準確,但既慢又貴,所以改為訪問 300 人:總體是全部 40,000 名學生;樣本是被問到的那 300 人。
「總體越大,樣本就要按比例越大,所以 1% 的樣本只有在總體很小的時候才夠用。」 樣本大小不必跟隨總體大小按比例增加:全國性民意調查靠大約 1,000 至 2,000 人的樣本,就能描述人數以億計的總體,因為樣本是怎樣選出來的,遠比它佔總體多大比例重要。「樣本基本上就是總體的縮影,所以樣本裡成立的事,在總體裡也一定成立。」 樣本是關於總體的證據,不是總體的縮影;後面幾節會講這些證據怎樣誤導人。
參數描述總體,統計量描述樣本
參數(parameter)是描述總體的一個數;統計量(statistic)是描述樣本、並用來估計參數的一個數。
問這個數是從什麼算出來的。從整個算出來的是參數,實際上總體往往無從得知,參數常寫作 。只從你實際收集到的樣本算出來的是統計量,寫作 。設總體大小為 ,樣本大小為 :參數是固定的,通常未知;統計量是已知的,但只是參數的一個估計。
一所學校有 4,000 名學生(),它的真實平均 GPA 沒有人知道。你訪問了 50 名學生(),算出 。這個 3.1 是真實的,也算得正確,但它描述的是你那 50 名學生,不是全部 4,000 人。
「樣本平均數就等於總體平均數,抽樣的意義就在這裡。」 不是: 是 的估計,由你手上真正有的數據算出來,代替一個你沒有的數。「參數和統計量只是同一樣東西的兩個叫法。」 兩者按定義就是不同的東西:把一項民調的統計量當成總體的參數、不帶任何不確定性,是各種研究最常被誤讀的方式之一。
建立一個不會騙你的樣本
當收集樣本的方法令中某些成員比其他成員更容易或更不容易被選入,這個樣本就有抽樣偏差(sampling bias),無論多大也不能代表總體。
問這個方法是否給總體中每一個成員一個已知而公平的機會,而不是問研究者有沒有親手挑人。簡單隨機樣本(simple random sample)直接做到這一點;幾種標準的變化做法不同,但同樣公平。只找最容易找到的人,或者讓人自行決定參與,都不合格。
一家商店在某個下午訪問當時正在店內閒逛的顧客來量度滿意度(假設的例子),這是方便樣本(convenience sample)。方法本身就把當時不在店內的所有人排除在外,這種偏差叫覆蓋不足(undercoverage)。
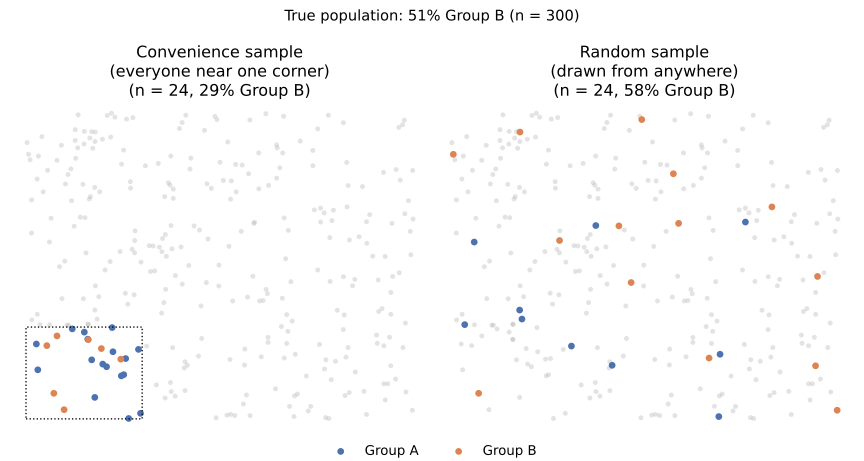
「隨機抽樣就是隨手找身邊或容易接觸到的人。」 那是方便,不是隨機:隨機的方法給每個成員一個已知的機會,隨手抓人永遠做不到。「只要回應的人夠多,樣本無論怎樣選都沒問題,大樣本不會有偏差。」 用同一個有缺陷的方法收集更多回應,只是把缺陷重複更多次,下面的案例正是這樣。「讓人自己決定要不要回應,是最公平、最沒有偏差的建立樣本方式。」 這叫自願回應(voluntary response):意見強烈的人回應的比率遠高於其他人。
1936 年,一本很受歡迎的美國雜誌《文學文摘》(Literary Digest)就總統選舉寄出大約一千萬份問卷,收回約 240 萬份,樣本比今天任何民調所用的都大得多。它預測挑戰者會輕鬆勝出;結果在任者以壓倒性優勢勝出。雜誌的郵寄名單來自它自己的訂戶、汽車登記紀錄和電話簿,而在 1936 年,這些名單偏向較富裕、較少受大蕭條衝擊的家庭;收到問卷的人只有約四分之一回覆,在覆蓋不足之上再加了一層自願回應。幾百萬份回應救不了一個有缺陷的方法。
同一個總體,不同的樣本,不同的數字
抽樣變異性(sampling variability)是從同一個總體抽出的不同隨機樣本所算出的之間自然存在的差異:這是意料之中的隨機變異,不是。
兩個同樣大小、老老實實隨機抽出的樣本,幾乎不會產生一模一樣的統計量,而且兩個都沒有「錯」。要問的是它們為什麼不同:碰巧抽到不同的人,是變異性;方法偏袒某些人,就是了。
回到那個例子:4,000 名學生的學校。你隨機訪問 50 名學生,得到平均 GPA 3.1;一位同學另外隨機訪問 50 名,得到 3.4。你們兩個都沒有做錯,只是沒有訪問同一批人。
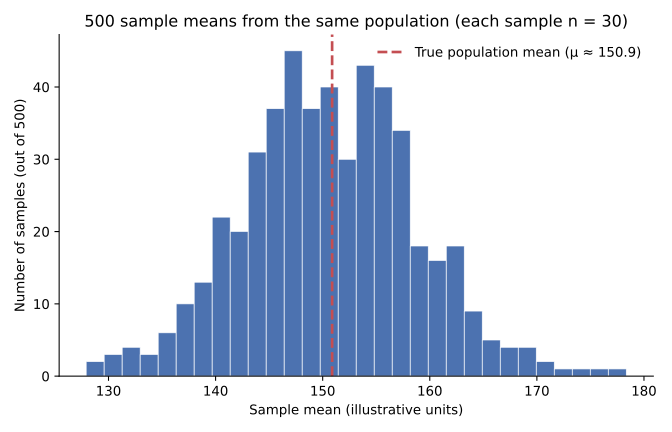
「如果我用一個新樣本再做一次調查,應該得到跟之前一樣的數字;結果不同,就是有地方出錯了。」 沒有出錯:公平的方法每一次抽出的結果仍然會不同,因為它碰巧抽到誰是隨機的,隨機就是這個意思。「抽樣變異性和抽樣偏差基本上是同一個問題,都只是說樣本不可信。」 不是:偏差來自樣本是怎樣選出來的;變異性來自公平的方法碰巧選中了哪些成員,而且即使消除了偏差,變異性仍然存在。
分類還是定量:這是哪一種數據
分類數據(categorical data,又叫定性數據 qualitative data)把每個個體歸入一個組別或貼上一個標籤;定量數據(quantitative data)是計數或量度的結果,對它做算術是有意義的。
不要理會一個值是用數字還是文字寫的。問把兩個值相加或取平均,得出的答案有沒有任何意思。有,就是定量數據。沒有,就是分類數據。
班上的學生名單記錄一名學生的髮色是「啡色」,學生編號是「10583」。髮色是分類數據。編號雖然全是數字,也是分類數據:把兩個編號取平均,或者說一個編號「大於」另一個,都沒有意思,它只是一個披着數字外衣的標籤。
「寫成數字的就是定量數據,寫成文字的就是分類數據。」 電話號碼、巴士路線號碼和球衣號碼全是數字,按上面的算術測試,仍然是分類數據。「分類數據不能真正用數字分析,只能用文字描述。」 你可以點算每個類別有多少個體,再比較這些數目或比例;不能做的是把類別本身取平均,因為「啡色」加「金色」除以二,並不是一種髮色。
點算還是量度:離散數據與連續數據
離散數據(discrete data)來自點算,只取一個個分開、可以逐一列出的值,值與值之間有真正的空隙;連續數據(continuous data)來自量度,可以落在一個尺度上的任何位置。
問在兩個相鄰的數據點之間,原則上有沒有可能出現一個嚴格介乎其間的值。有,就是連續數據。沒有,就是離散數據。有沒有小數不是判準:離散的計數取平均後可以是小數,連續的量度也可以剛好落在整數上。
假設一班有 30 名學生,兄弟姊妹的數目和以厘米計的身高都是。兄弟姊妹的數目來自點算:2 和 3 之間沒有任何有效的值,所以是離散數據。身高來自量度:一個值可以落在 162 至 163 厘米之間的任何位置,所以是連續數據。
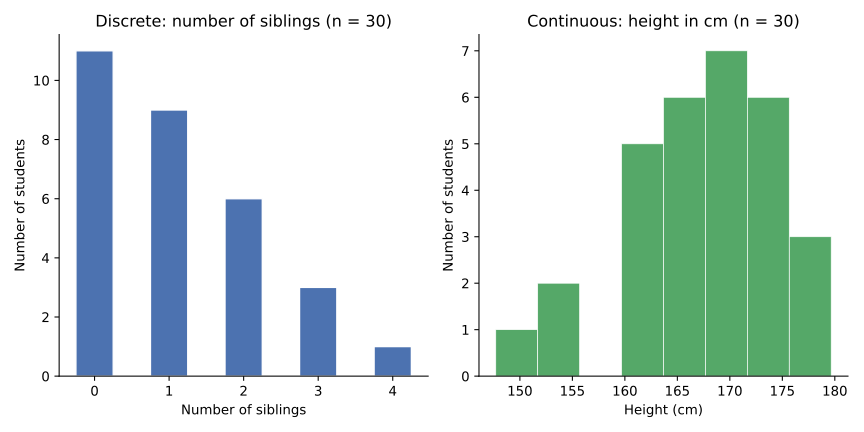
「數字有小數,數據就是連續的;是整數,就是離散的。」 離散的計數取平均後可以是小數:「平均每名學生有 1.8 個兄弟姊妹」很正常,雖然沒有任何一名學生有 1.8 個兄弟姊妹;小數屬於平均數,不屬於任何一個單獨的計數。「連續只是說數據裡有很多不同的值。」 連續的量度也可以碰巧剛好落在整數上,例如一名學生真的高 170.0 厘米;重要的是中間的值有沒有可能出現。
把各部分拼起來綜合運用
最後一個假設的例子:一所大學想知道學生比較喜歡網上課堂還是面授課堂。這又是的區分:全體學生,對比你實際收集到的那些人。
站在校園廣場逢人便問,是一種叫覆蓋不足的問題:那個時候不在那裡的學生沒有機會被問到。把問卷放上網、來者不拒,則有相反的偏差,就是自願回應,令強烈的意見比例過高。你想要的是更接近簡單隨機樣本的做法,給每一名學生一個已知而公平的機會。
無論你得到什麼樣本,樣本中偏好網上課堂的比例是一個統計量:它是你對真實的最佳證據,而參數是全校學生的實際比例,永遠無法準確知道。同學做一個同樣有效的調查,得到一個稍為不同的數字,那是平常的,不是錯誤。
順帶一提:學生的偏好是;修讀過多少個網上課堂是定量而離散的數據;每星期的通勤時數是定量而的數據。這六個概念沒有一個是可有可無的:每一個都是一個信心十足的數字誤導你的方式,只要你不先問它是哪一種數字。