概率與統計第 2 章
Descriptive Statistics
本章目錄
一列數字還不算是對任何東西的描述。這一章把原始數據變成一小組圖和數字,說出數據實際上是什麼樣子:它的形狀、中心和離差。每一個工具都建立在上一個之上,從開始,一直到章末的。
解讀直方圖:數據堆在哪裡
直方圖(histogram,又稱組織圖)把的數值按等闊的區間分組,每個區間叫做一組(bin,即組區間),然後在每一組上畫一個直條,高度是該組所含數值的數目或比例。
檢查兩件事:直條彼此相接,因為各組在同一條連續的尺度上共用邊界;直條的高度代表頻數,從來不是原始數值本身。幹葉圖、折線圖或棒形圖也可以顯示數據,但只有直方圖會這樣把取值範圍很闊的定量變量分組。
一個訓練營記錄了 60 名學員的完成時間,以小時計(假設的例子)。分入等闊的組之後,大部分直條聚集在中段,另有一兩個較矮的直條伸向一邊:這正是直方圖存在的目的,在算出任何一個數字之前,先讓你一眼看到這個形狀。
「直方圖不過是棒形圖,所以直條可以隨便重新排列,怎樣好看就怎樣排。」 棒形圖的類別本身沒有次序,直條是分開畫的;直方圖的組是數值,次序固定,而且彼此相接,因為次序本身就是這幅圖要顯示的一部分。「最高的直條顯示的是最常見的那一個值。」 它顯示的是數值最多的那一組,而一組可以包含許多不同的值:直方圖犧牲了個別的值,換來數據整體形狀的一覽。
百分位數與四分位數:一個值在數據中的位置
第 p 個百分位數(p-th percentile)是這樣一個值:有百分之 p 的數據落在它以下。四分位數(quartile)是把已排序的數據切成四個大小相等的組的那三個百分位數:(第 25 個百分位數)、中位數(第 50 個)和 (第 75 個)。
先把數據排序:在未排序的列表上,百分位排名沒有意義。要定位一個值,問已排序的數據有多大比例落在它或它以下,而不是問它本身有多大。四分位數間距(interquartile range),,量度中間一半數據的闊度;一個值若低於 或高於 超過 ,就會被標示為可能的異常值(outlier)。
一個假設的分班試以百分位數報告成績。一個成績位於第 40 個百分位數,意思是 40% 的應試者得分等於或低於它:大部分應試者的得分都比它高,雖然 40 在 100 之中聽起來很中等。
「考到第 90 個百分位數,即是答對了 90% 的題目。」 百分位排名是拿你跟其他應試者比較,不是跟滿分比較:只要其他人考得更低,第 90 個百分位數的成績可以只是原始分數 65%。「 和 跟中位數的距離永遠相等。」 只有對稱的數據才是這樣:四分位數由名次定義,不是由距離定義,所以偏向一邊的數據往往在一邊伸得更遠。
框線圖:五個數字,一幅圖
框線圖(box plot,又稱箱形圖或 box-and-whisker plot)把一組數據的五數概括(five-number summary),即最小值、、中位數、、最大值,畫成一幅圖:一個由 至 的框,框內在中位數處畫一條線,再從框向兩端伸出鬚(whisker)至最小值和最大值。John Tukey 在 1977 年的一本書中令這種圖普及起來。
框的闊度就是,框內是中間一半的數據;它顯示這一半從哪裡開始、到哪裡結束,不是裡面有多少個點。中位數線在框內偏離中央,或者一邊的鬚比另一邊長得多,都在做任何算術之前就標示出一個偏向一邊的分佈。
一家補習社(假設的例子)抽取了 9 名學生作樣本,記錄他們在小測前用溫習卡溫習的分鐘數:12、15、18、20、22、25、28、33 和 60,其中一名學生溫習的時間遠比其他人長。下面的例題詳解逐步畫出它的框線圖。
- 把數據排序。 12、15、18、20、22、25、28、33、60(已經排好序;)。
- 找中位數。 是奇數,所以中位數是中間(第 5 個)的值:22。
- 找 。 較低的四個值(12、15、18、20)的中位數: 。
- 找 。 較高的四個值(25、28、33、60)的中位數: 。
- 寫出五數概括。 最小值 、、中位數 、、 最大值 ;框由 16.5 畫到 30.5,中位數線畫在 22,鬚伸到 12 和 60。
常見失誤:分成兩半之前忘了重新排序;以及 是奇數時把中位數本身同時算進兩半,令 和 移位。
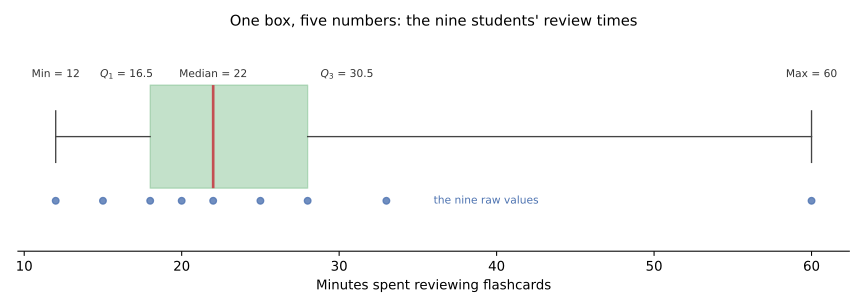
「框越闊,即是裡面塞了越多數據。」 跟直方圖不同:框的闊度顯示中間一半的數據有多分散,不是那裡有多少個點;框線圖完全不帶任何頻數資訊。「框裡面那條線是平均數。」 那是中位數;標準的框線圖不標平均數,而當數據偏斜時,平均數可以落在框外很遠的地方。
平均數、中位數與眾數:三種中心
平均數(mean)是把每一個值加起來再除以值的數目,樣本的寫作 ,總體的寫作 。中位數(median)是已排序數據的中間值,數目是偶數時則是中間兩個值的平均。眾數(mode)是出現最多次的值;一組數據可以沒有眾數,也可以有一個或幾個。
平均數用到每一個值的大小,所以一個極端值會把它拉動;中位數只用名次,幾乎不動。沒有任何值重複時,這組數據就沒有眾數:這是一個有效的描述,不是數據有缺口。
上面裡的同一批 9 名學生,分別花了 12、15、18、20、22、25、28、33 和 60 分鐘。平均數是 ;中位數,即排序後第 5 個值,是 22。九個分鐘數各不相同,所以沒有眾數。
「平均數永遠是最好的中心量度,所以永遠應該報平均數。」 這裡的平均數 25.9 被那名學生的 60 分鐘拉高,比其他所有值都大,只有一個值例外;中位數 22 則更能代表一名典型的學生。兩者都沒有錯,但挑一個看起來較好的來報,就是不誠實。「每組數據都剛好有一個眾數。」 一組數據可以像這裡一樣沒有眾數,也可以有一個,或者有幾個同樣常見的值。
偏斜:當尾部把平均數拉走
一個分佈的一條尾部比另一條伸得更遠時,這個分佈就是偏斜(skewed)的;兩條都沒有伸得更遠時,就是對稱(symmetric)的。偏斜把拉向長尾那邊,而中位數會抵抗這種拉力,所以兩者之間的差距就把偏斜顯示了出來。
先找出較長的尾部,再按它命名偏斜:尾部向右伸就是右偏,向左伸就是左偏。裡偏離中央的中位數,往往是最先看得見的跡象。右偏的數據平均數通常大於中位數,左偏的數據通常相反;OpenStax 指出,這只是一個概括,在某些離散數據集上可能不成立。
回到那 9 名學生: 25.9 在中位數 22 之上,被那一個 60 分鐘的異常值拉高了。這是一個右偏的:長尾在右,大部分學生擠在低的一端。
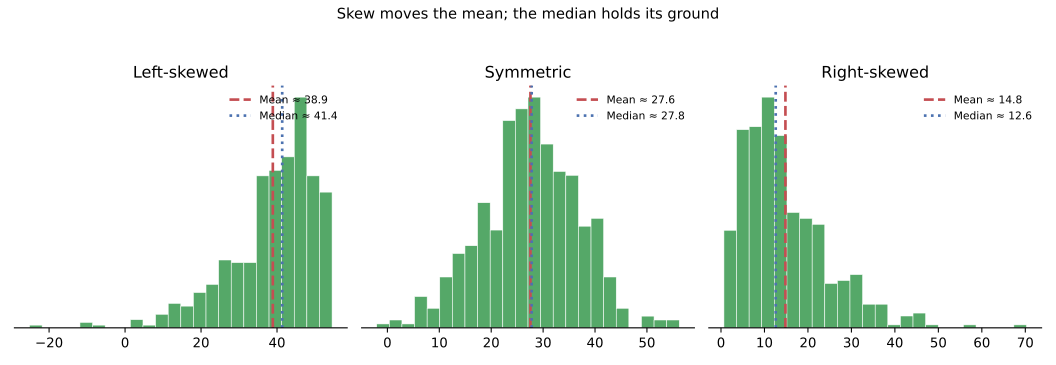
「右偏即是大部分數據在右邊。」 剛好相反:在右邊的是尾部,不是大部分數據;大部分的值和眾數都在低的一邊,也就是直條最高的地方。「就算數據偏斜,平均數仍然是最有代表性的量度。」 偏斜正是把平均數從大部分數據所在之處拉走的東西;抵抗這種拉力,正是中位數的職責。
標準差與方差:量度離差
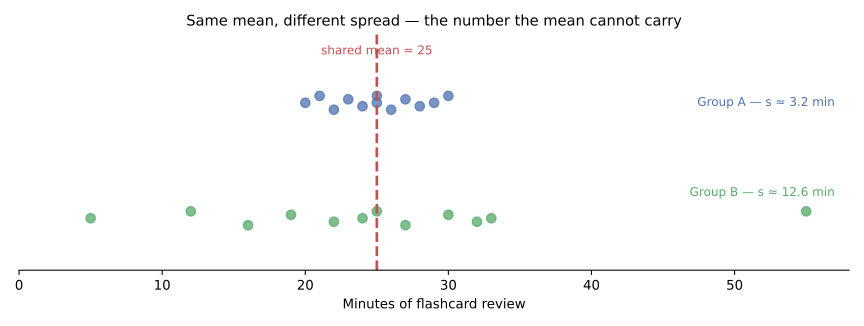
標準差(standard deviation)量度數據值與之間的典型距離,以數據本身的單位計;方差(variance)是同一個概念在開平方根之前的平方單位版本。樣本用 ,除以 ;總體用 ,除以 。
問一個離平均數「典型」的距離是什麼樣子,而不只是問兩個極端值之間的距離:標準差用到每一個值,所以一個離得遠的點會令它移動,但遠不及它令分佈域(range)移動得那麼多。兩組數據可以平均數相同、分佈域相同,標準差卻相差很遠。
同一批 9 名學生的分鐘數給出 。下面的例題詳解逐步算出樣本標準差 。
- 求平均數。 。
- 求每個偏差並取平方。 例如 ,平方後 ;對全部九個值重複做一次。
- 把偏差平方加起來。 。
- 除以 。 ,這就是樣本方差。
- 開平方根。 分鐘。
常見失誤:樣本除以 而不是 ,令 偏小。
「標準差較大,只是說那些數字本身較大。」 數值大小和離差是兩回事:90 多分的考試分數,逐個值之間的變化可以比 20 多歲的年齡更大。「標準差和分佈域量度的基本上是同一樣東西。」 分佈域只用兩個極端值;標準差用到每一個值,所以一個偏離的點會令分佈域大幅移動,令標準差只是輕微移動。
從頭到尾描述一組數據綜合運用
把九名學生用溫習卡溫習的分鐘數放進本章每一個工具,它們講的是同一個故事。許多這樣的樣本畫成,會在低的一端顯出一個高聳的堆,向高的一端則是一條漸漸變薄的尾部。 16.5 和 30.5 把中間一半框住;由它們畫出的顯示中位數線靠近框的低邊而不是高邊,這是在做任何算術之前偏斜的視覺線索。 25.9 和 22 相差接近四分鐘,那個差距就是化成數字的:那一個 60 分鐘的異常值把平均數拉向尾部,中位數則紋絲不動。大約 14.3 分鐘,說的是一名典型學生的時間離那個被拉高的平均數有多遠;如果手上還沒有形狀、中心和四分位數,這個數字幾乎沒有意思。這裡沒有一幅圖能代替數字,也沒有一個數字能代替圖;只有兩者一致,一組數據才算描述完整。
資料來源
- 1 OpenStax Introductory Statistics §2.1: Stem-and-Leaf Graphs (Stemplots), Line Graphs, and Bar Graphs — 來源
- 2 OpenStax Introductory Statistics §2.2: Histograms, Frequency Polygons, and Time Series Graphs — 來源
- 3 OpenStax Introductory Statistics §2.3: Measures of the Location of the Data — 來源
- 4 OpenStax Introductory Statistics §2.4: Box Plots — 來源
- 5 OpenStax Introductory Statistics §2.5: Measures of the Center of the Data — 來源
- 6 OpenStax Introductory Statistics §2.6: Skewness and the Mean, Median, and Mode — 來源
- 7 OpenStax Introductory Statistics §2.7: Measures of the Spread of the Data — 來源
- 8 Wickham & Stryjewski, "40 Years of Boxplots" (on John Tukey's 1977 introduction of the box plot) — 來源
- 9 R stats::quantile documentation — nine quantile types after Hyndman & Fan (1996); type 7 is R's default — 來源
- 10 NIST/SEMATECH e-Handbook of Statistical Methods §1.3.3.7: Box Plot (the fence-based box plot is a variation; whiskers end at the farthest observations inside the inner fences) — 來源
- 11 R graphics::boxplot documentation (default range = 1.5; whiskers end at the most extreme data point within range and outliers are drawn as points) — 來源
- 12 Matplotlib 3.11.1 pyplot.boxplot documentation (default whis = 1.5; whiskers end at the farthest data within the cutoff and values beyond are plotted as outliers) — 來源