概率与统计第 5 章
Continuous Random Variables
本章目录
这一章把第 1 章的之分,从已经收集的数据延伸到取值还未知的随机变量:当可能的结果填满一个区间,而不是一张可以逐一数出来的清单时,概率必须以曲线下的面积来度量,不能从一张结果表读出来。由这一个想法出发,本章建立两个标准的连续模型:均匀分布在区间上的平坦密度,以及指数分布对随机等待的建模,包括让它与众不同的无记忆性。
结果填满一个区间,而不是一张清单
当一个随机变量的可能结果填满数轴上的一个区间,而不是形成一张一个个分开、可以逐一列出的清单,这个随机变量就是连续型(continuous)的:这正是第 1 章用在数据上的离散/连续测试,在这里用于一个还没有被观察的结果。
问原则上能不能出现一个严格介于两个值之间的值。计数得到的事件数、成功次数或商品件数不能;测量出来的时间、长度或分量可以,无论你看得多仔细。
假设一名顾客在自动售货机前的决定时间可以落在一段秒数的任何位置;同一名顾客买的商品件数不能落在 2 和 3 之间。前者是连续的;后者是离散的。
“秒表只显示两位小数,所以时间本身一定是离散的。” 显示屏对一个连续的量做了四舍五入,并没有改变被测量的是什么:真正经过的时间原则上仍然可以落在中间任何位置。“连续型变量还是可以逐一列出来的,只是值很多而已。” 任何两个连续的值之间总夹着另一个值,没完没了:没有“下一个值”可以列,这正是为什么前几章那种靠清单的概率需要换成面积。
概率是密度曲线下的面积
概率密度函数(probability density function) 这样描述一个连续型随机变量:概率是它的曲线之下、某个区间上的面积,而不是曲线在单独一点的高度。
对任何区间,概率就是面积:平坦的一段是底乘以高,更一般地是曲线下的区域,而所有可能的值上的总面积恰好是 1。对任何一个确切的值,区间的宽度为零,所以面积、也就是概率,是零:。
假设一个转盘落在 0 到 10 的区间上任何位置,密度平坦,为 0.1。它落在 2 到 6 之间的概率是这个矩形的面积,;它恰好落在 的概率是 。
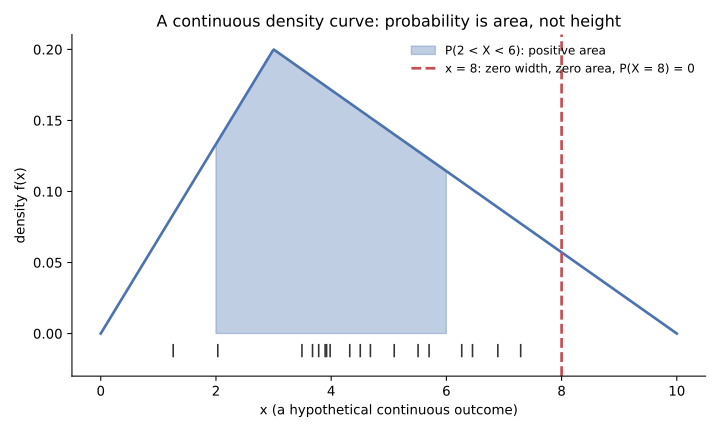
“恰好在 的概率就是曲线的高度 。” 是密度,不是概率:它要乘上一个宽度才会变成概率,而单独一点的宽度是零。“既然对每一个 都有 ,那就没有任何值真的可能出现。” 总有某个值会出现;只是没有任何单独的值自己带有正概率,只有区间才有。
均匀分布:区间上一片平坦的密度
当连续型随机变量 的密度对 与 之间的每一个 都是常数 ,它就服从均匀分布(uniformly distributed),记作 。
确认密度在一个固定的区间 上是平坦的。是的话,任何子区间 的概率就是面积:宽度乘以那个常数高度,,无论这个子区间位于 的哪个位置。它的中心和离散程度单由两个端点决定:,。
假设一辆校园班车在整点后 0 到 24 分钟的任何一分钟到站的可能性都相等:,所以在这个区间上 。
- 确认密度。 ,所以对 内的每一个 ,。
- 求区间的宽度。 对 ,宽度是 。
- 宽度乘以高度。 。
常见失误:只用区间的宽度而没有乘以 ;两个端点相减的顺序弄反。
“一个区间的概率就是它的宽度。” 单看宽度漏了高度:一个 6 分钟的时段是 ,不是 6。“‘均匀’是说每一个确切的值都是等可能的,就像一枚骰子的六个面一样。” 密度是常数,但每一个单独的值的概率仍然是零,正如上一节所确立的:“均匀”形容的是平坦的曲线,不是等可能的点。
指数分布:为随机等待建模
指数分布(exponential distribution) 为直到某个随机事件发生为止的等待时间建模,密度为 ,;其中率参数(rate parameter) 是平均等待时间的倒数,,而这个参数在本书以外几乎都写作 。它的标准差等于它的均值。
问这个量是不是等到某件事发生为止的等待,而且短等待比长等待常见。的密度是平坦的;指数密度在 最高,随着 增大而缩小,累积概率为 。
工单陆续进来,等下一张进来的平均等待时间是 5 分钟(假设的例子):,因为 。
- 求率参数。 平均等待时间 分钟,所以 。
- 套用累积分布函数(cumulative distribution function,CDF (累积分布函数))。 。
- 代入计算。 。
常见失误:把均值 而不是它的倒数代入 ;漏掉指数上的负号。
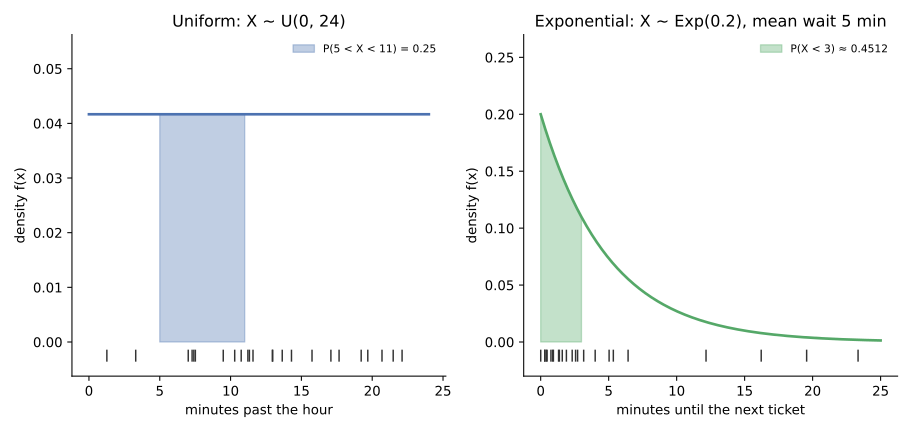
“率参数就是平均等待时间,所以 表示典型的等待是 0.2 分钟。” 率计数的是每单位时间内的事件数,而平均等待时间是它的倒数: 分钟。因此 越大,事件来得越频繁,等待越短,而不是越长。“一个固定的率,表示等待是等距出现的。” 率描述的是许多次等待的平均,不是任何一次等待的模式:个别的等待时间随机变化,通常很短,偶尔很长。
无记忆性:为什么等待会忘记过去
的无记忆性(memoryless property)是指,存活到时间 对剩余的等待没有任何改变:对每一个 ,。
把“已知已经存活到 ,再存活 个单位”的条件概率,跟“重新抽一次,从零开始存活 个单位”的概率比较。对指数分布来说,两者在代数上永远相等;对大多数其他分布则不然。
假设一个元件的寿命均值是 8 年,所以它的率参数是 。它已经运行了 3 年,再用 5 年的概率等于一个全新元件用 5 年的概率:。
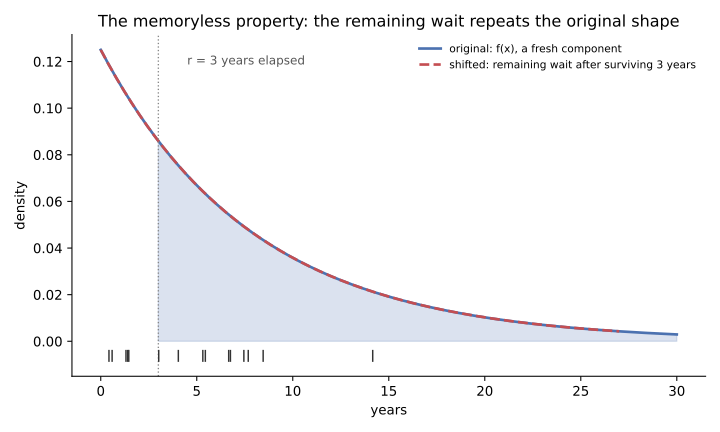
“无记忆性是说元件不会老化。” 只在狭义上成立:这个模型没有内置磨损;它不是说物理上什么都没有变,只是说过去的存活对剩余的等待不带任何概率上的信息。“已经存活了异常长的时间,它一定‘该’快要失效了。” 这是赌徒谬误式的解读;这个性质说的恰好相反:已经过的时间永远不会提高或降低剩余等待的概率。
把连续概率用起来综合运用
再来一个假设的例子:急诊室的等待时间。在测量之前,这个等待是一个随机变量:它可以落在一段分钟数的任何位置,不是一张固定的清单,所以它的概率是,不是一张列出各种机会的表,而它恰好等于任何一个确切分钟数的概率都是零,无论那一段感觉上多么可能。
如果范围内每一种等待长度都同样说得通,就合用:密度是常数,宽度相等的时段无论落在哪里都带有相等的概率。真实的等待通常不是这样:短等待一般比长等待常见,于是改为用上,它的密度在零最高,随着等待增长而下降,由一个参数决定,而这个参数是平均等待时间的倒数。
指数模型还带着一个更进一步、更尖锐的主张,就是它的:一名已经等了 20 分钟的患者,再等 10 分钟的可能性跟一名刚走进来的患者相比,既不更高也不更低;“已经等了很久”本身并不是等待快要结束的证据。
资料来源
- 1 OpenStax Introductory Statistics §5.1: Continuous Probability Functions — 来源
- 2 OpenStax Introductory Statistics §5.2: The Uniform Distribution — 来源
- 3 OpenStax Introductory Statistics §5.3: The Exponential Distribution — 来源
- 4 NIST/SEMATECH e-Handbook §1.3.6.6.2: Uniform Distribution (mean (A+B)/2, standard deviation sqrt((B-A)^2/12)) — 来源
- 5 SciPy scipy.stats.expon documentation — the exponential is parameterized by the rate lambda, supplied as scale = 1/lambda — 来源