概率与统计第 4 章
Discrete Random Variables
本章目录
这一章把一个随机试验变成一个你可以拿来计算的数:离散型、它的,以及不用列出每一个结果就能描述它的两个概括性的数字:和。章末讲离散型随机变量在实践中最常见的一种形状:,以及求它自己的均值和标准差的。
什么是随机变量
随机变量(random variable)在结果未知之前,把一个数赋予随机试验的结果;当它的可能取值可以逐一数出、逐一列出,值与值之间有真正的空隙时,它就是离散型(discrete)的。
问两件事:它是否把一个数赋予一个尚未知道的结果?是的话,它就是随机变量。然后套用第 1 章判断时用的同一个“计数还是测量”测试:一个值可以严格落在两个相邻的可能取值之间吗?不可以的话,它就是离散型的。
一位餐车老板记录随机选出的一个午餐时间内食物过敏特殊订单的数目(假设的例子)。这个计数只能是 0、1、2、3,依此类推,1 和 2 之间没有任何有效的值,所以它是离散型随机变量。
“写下‘X = 3’和说‘有 30% 的机会’是同一类的陈述。” 不是: 指的是变量可能取的一个值,而 指的是这个值有多大可能出现;随机变量和它的概率是不同的东西。“离散型随机变量的取值一定是从 0 开始的连续整数。” 离散只要求取值可以列出、值与值之间有真正的空隙;负数、跳过某些值,或者间距不均,仍然是离散的。
建立一个有效的概率分布
离散型随机变量的概率质量函数(probability mass function),简称 PMF (概率质量函数),把它能取的每一个值与该值的概率配对。
一张表只有在两条规则都成立时才是有效的 PMF (概率质量函数):每一个概率都介于 0 和 1 之间(含),而且所有概率加起来恰好等于 1。只符合其中一条并不够。
餐车老板为每个午餐时间 0、1、2 或 3 份特殊订单拟了一张表:概率是 0.35、0.30、0.25、0.10。每一个都介于 0 和 1 之间,而且加起来等于 1,所以这张表是有效的 PMF (概率质量函数)。
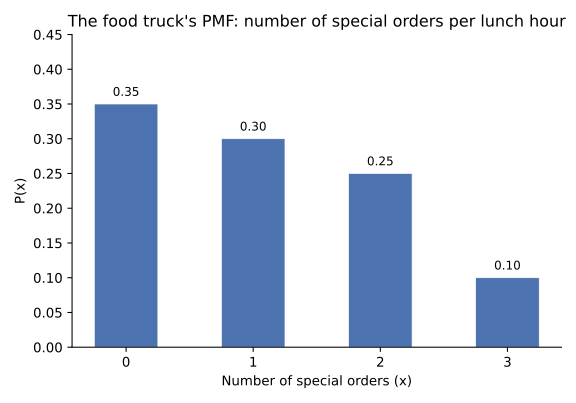
“只要每一个数都是合法的概率,这张表就算有效。” 单靠这一点并不够:一张 0.35、0.30、0.25、0.20 的表有四个看似合法的数,加起来却是 1.10,在理应涵盖所有可能性的结果之上,声称的机会超过了必然。“概率分布一定要把概率平均分给每一个值,否则就不算真正随机。” 没有任何规定要求概率相等;只要上面两条规则都成立,一个大幅偏向某一个值的分布,和一个平均的分布完全一样有效。
均值:长期平均值
均值(expected value,也叫数学期望)记作 ,是离散型随机变量在多次重复之下的长期平均结果。
把每个可能的值乘以它自己的概率,再把乘积相加:。这描述的是多次重复之下结果集中在哪里,不是任何单独一次试验会发生什么。
就餐车的表而言,从 0.35、0.30、0.25、0.10 算出的 是一个不属于 0、1、2、3 任何一个的长期平均值,下面逐步展示。
- 列出每个值和它的概率。 从表中:,。
- 把每个值乘以它的概率。 ;;;。
- 把乘积相加。 份特殊订单。
常见失误:把四个 值直接取平均而完全不按概率加权;把乘积的总和除以结果的数目(4),这样就把第 2 步已经做过的加权重复算了一次。
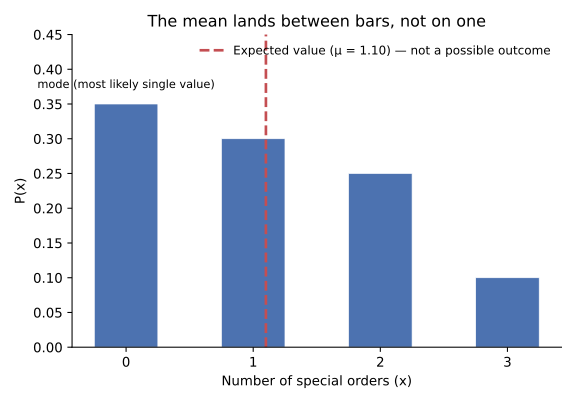
“均值就是你在任何一次试验中最预期会看到的值,也就是最可能出现的结果。” 那个量是众数,而且经常和 不一致:这里 0 是单一最可能出现的计数,概率是 0.35,但 。“既然是平均数,均值一定是变量能取的其中一个值。” 不必:整数的平均数很少本身也是整数,就像一个班的平均兄弟姐妹数目可以是 1.8,却没有任何学生真的有 1.8 个兄弟姐妹。
标准差:结果通常偏离多远
标准差(standard deviation)记作 ,衡量随机变量的结果通常偏离它的 多远。
把每个值与 的距离平方,让高于和低于的距离不会互相抵消,再按各自的概率加权、相加,然后开平方根:。
就餐车的表而言,;把每个值与 1.10 的距离的平方按其概率加权再相加,得 0.99,所以 份特殊订单。
“标准差是 0 说明计算出错了,因为随机变量理应会变化。” 这不是错误: 正确地描述了一个永远取同一个值、完全没有变化的随机变量。“标准差和均值基本上衡量的是同一回事。” 它们回答不同的问题: 问结果集中在哪里; 问结果通常离那里多远,两个随机变量可以其中一个相同而另一个差别很大。
二项分布,以及它什么时候适用
二项随机变量(binomial random variable)计算 次独立试验中成功的次数,每次试验都有相同的两个可能结果和相同的成功概率 ;记作 。
三个条件一起检查:固定的试验次数 ;每次试验恰好两个结果,成功(概率 )和失败(概率 );以及各次试验相互独立, 从一次试验到下一次都不变。
一位篮球运动员的罚球命中率是 70%,每一次罚球都视为与其他各次独立(假设的例子),她罚球 8 次。“命中的球数”是二项的,,。她恰好命中 6 球的概率是多少?
- 确认条件,找出 、、。 固定次数、两个结果、独立而概率不变,全部成立;这里 ,,,目标 。
- 计算排列方式的数目。 :在 8 次罚球中,6 次命中、2 次不中可以出现的顺序有这么多种。
- 计算其中一种排列的概率。 。
- 相乘。 :恰好命中 6 球的机会大约是 30%。
常见失误:漏掉 ,得出的是命中和不中某一种特定顺序的概率,而不是全部顺序;把指数交换成 ,算出来的是 次不中而不是 次成功的概率。
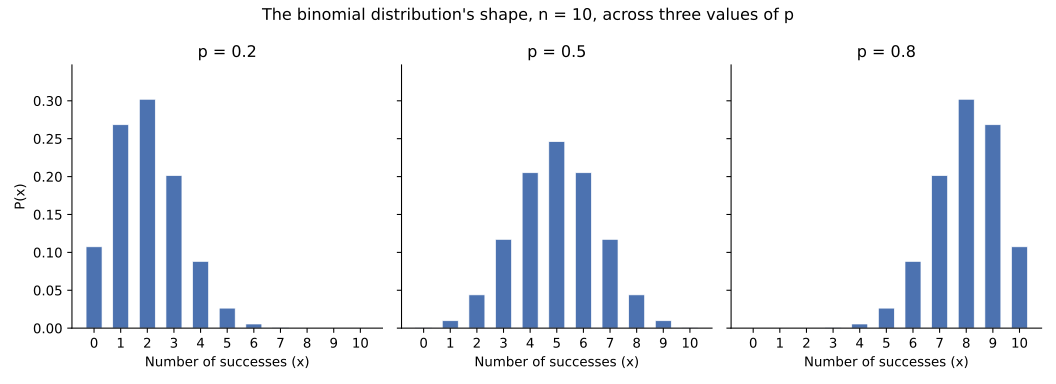
“任何‘若干次尝试中的成功次数’都算是二项的。” 各次尝试会互相影响的话就不算:不放回地抽 8 张牌来数红色的牌,每一次抽牌都改变概率,破坏了独立性;那里适用的是另一种分布。“‘至少’可以用计算恰好那个数目的概率来回答。” “至少命中 6 球”问的是一个范围: 和 合在一起,而不是单独的 一个值。
二项随机变量的均值与标准差
二项随机变量的和可以简化为 和 ,不需要完整的分布列。
均值: 乘以 ;标准差: 乘以 再乘以 ,然后开平方根。两者对任何有效的 都成立,不只是 。
对那位罚球球员来说,,,:预期命中 球; 球。
“简便公式 只在 时才适用。” 它对每一个有效的 都成立; 只是最容易手算验证的情况,因为在那里成功和失败的可能性相等。“ 一定是整数,对应一个实际可能的计数。” 这里 ,在一场比赛的 8 次罚球中她永远不可能恰好命中这个数;那个“平均数不需要是可以达到的值”的事实,同样适用于这条简便公式。
一次看到整个分布综合运用
最后一个假设的例子:一个呼叫中心,每一个来电都以 0.6 的概率独立地一次解决,一位主管记录每 5 个来电中一次解决的数目。
这个计数是一个:附在一个尚未观察到的结果上的数,取 0 到 5 这些可以列出的值。写出它的,就是把这六个值各自配上一个概率,而只有当每一项都介于 0 和 1 之间、六项加起来恰好等于 1 时才有效。每一次试验都独立,有相同的两个结果和相同的固定概率,所以这个计数也是二项的,,它的和都化为只含 和 的简短算式。
描述的是很多组五个来电的长期平均值,不是对这一组的保证; 描述的是典型的一组偏离这个平均值多远。两个数都不承诺接下来会发生什么;合起来,它们描述了多次重复之下倾向发生什么的形状,一次以表的形式呈现,一次以公式的形式呈现。
资料来源
- 1 OpenStax Introductory Statistics §4.1: Probability Distribution Function (PDF) for a Discrete Random Variable — 来源
- 2 OpenStax Introductory Statistics §4.2: Mean or Expected Value and Standard Deviation — 来源
- 3 OpenStax Introductory Statistics §4.3: Binomial Distribution — 来源
- 4 NIST/SEMATECH e-Handbook of Statistical Methods §1.3.6.6.18: Binomial Distribution (states the closed-form PMF and the mean np, SD √(np(1−p))) — 来源