概率與統計第 4 章
Discrete Random Variables
本章目錄
這一章把一個隨機試驗變成一個你可以拿來計算的數:離散、它的,以及不用列出每一個結果就能描述它的兩個概括數字:和。章末講離散隨機變量在實踐中最常見的一種形狀:,以及求它自己的平均數和標準差的。
什麼是隨機變量
隨機變量(random variable)在結果未知之前,把一個數賦予隨機試驗的結果;當它的可能取值可以逐一點算、逐一列出,值與值之間有真正的空隙時,它就是離散(discrete)的。
問兩件事:它是否把一個數賦予一個尚未知道的結果?是的話,它就是隨機變量。然後套用第 1 章判斷時用的同一個「點算還是量度」測試:一個值可以嚴格落在兩個相鄰的可能取值之間嗎?不可以的話,它就是離散的。
一位美食車老闆記錄隨機選出的一個午膳時間內食物過敏特別訂單的數目(假設的例子)。這個計數只能是 0、1、2、3,如此類推,1 和 2 之間沒有任何有效的值,所以它是離散隨機變量。
「寫下『X = 3』和說『有 30% 的機會』是同一類的陳述。」 不是: 指的是變量可能取的一個值,而 指的是這個值有多大可能出現;隨機變量和它的概率是不同的東西。「離散隨機變量的取值一定是由 0 開始的連續整數。」 離散只要求取值可以列出、值與值之間有真正的空隙;負數、跳過某些值,或者間距不均,仍然是離散的。
建立一個有效的概率分佈
離散隨機變量的概率質量函數(probability mass function),簡稱 PMF (概率質量函數),把它能取的每一個值與該值的概率配對。
一個表只有在兩條規則都成立時才是有效的 PMF (概率質量函數):每一個概率都介乎 0 與 1 之間(包括兩端),而且所有概率加起來剛好等於 1。只符合其中一條並不足夠。
美食車老闆為每個午膳時間 0、1、2 或 3 張特別訂單擬了一個表:概率是 0.35、0.30、0.25、0.10。每一個都介乎 0 與 1 之間,而且加起來等於 1,所以這個表是有效的 PMF (概率質量函數)。
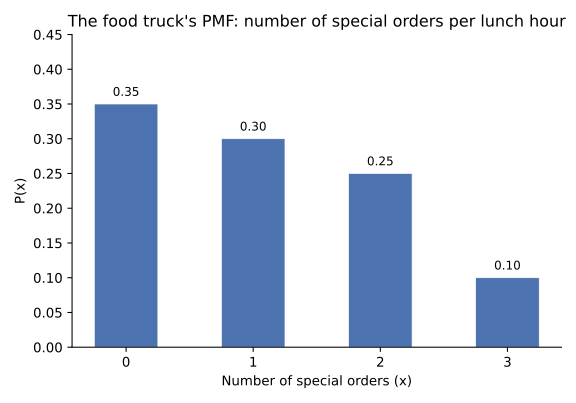
「只要每一個數都是合法的概率,這個表就算有效。」 單靠這一點並不足夠:一個 0.35、0.30、0.25、0.20 的表有四個看似合法的數,加起來卻是 1.10,在理應涵蓋所有可能性的結果之上,聲稱的機會超過了必然。「概率分佈一定要把概率平均分給每一個值,否則就不算真正隨機。」 沒有任何規定要求概率相等;只要上面兩條規則都成立,一個大幅偏向某一個值的分佈,跟一個平均的分佈完全一樣有效。
期望值:長遠平均
期望值(expected value)記作 ,是離散隨機變量在多次重複之下的長遠平均結果。
把每個可能的值乘以它自己的概率,再把乘積相加:。這描述的是多次重複之下結果集中在哪裡,不是任何單一次試驗會發生什麼。
就美食車的表而言,由 0.35、0.30、0.25、0.10 算出的 是一個不屬於 0、1、2、3 任何一個的長遠平均,下面逐步展示。
- 列出每個值和它的概率。 從表中:,。
- 把每個值乘以它的概率。 ;;;。
- 把乘積相加。 張特別訂單。
常見失誤:把四個 值直接取平均而完全不按概率加權;把乘積的總和除以結果的數目(4),這樣就把第 2 步已經做過的加權重複算了一次。
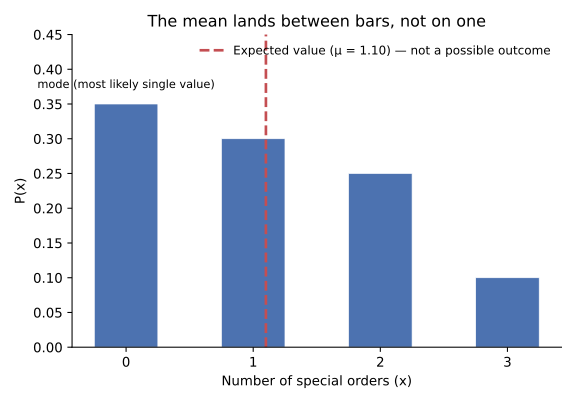
「期望值就是你在任何一次試驗中最預期會見到的值,也就是最可能出現的結果。」 那個量是眾數,而且經常跟 不一致:這裡 0 是單一最可能出現的計數,概率是 0.35,但 。「既然是平均數,期望值一定是變量能取的其中一個值。」 不必:整數的平均數很少本身也是整數,就像一班的平均兄弟姊妹數目可以是 1.8,卻沒有任何學生真的有 1.8 個兄弟姊妹。
標準差:結果通常偏離多遠
標準差(standard deviation)記作 ,量度隨機變量的結果通常偏離它的 多遠。
把每個值與 的距離平方,令高於和低於的距離不會互相抵消,再按各自的概率加權、相加,然後開平方根:。
就美食車的表而言,;把每個值與 1.10 的距離的平方按其概率加權再相加,得 0.99,所以 張特別訂單。
「標準差是 0 代表計算出錯了,因為隨機變量理應會變動。」 這不是錯誤: 正確地描述了一個永遠取同一個值、完全沒有變動的隨機變量。「標準差和期望值基本上量度的是同一樣東西。」 它們回答不同的問題: 問結果集中在哪裡; 問結果通常從那裡走開多遠,兩個隨機變量可以其中一個相同而另一個差別很大。
二項分佈,以及它什麼時候適用
二項隨機變量(binomial random variable)點算 次獨立試驗中成功的次數,每次試驗都有相同的兩個可能結果,成功的概率 也相同;記作 。
三個條件一起檢查:固定的試驗次數 ;每次試驗剛好兩個結果,成功(概率 )和失敗(概率 );以及各次試驗互相獨立, 由一次試驗到下一次都不變。
一位籃球員的罰球有 70% 會投中,每一次罰球都視為與其他各次獨立(假設的例子),她罰球 8 次。「投中的球數」是二項的,,。她剛好投中 6 球的概率是多少?
- 確認條件,找出 、、。 固定次數、兩個結果、獨立而概率不變,全部成立;這裡 ,,,目標 。
- 點算排列方式。 :在 8 次罰球中,投中 6 球、投失 2 球可以出現的次序有這麼多種。
- 計算其中一種排列的概率。 。
- 相乘。 :剛好投中 6 球的機會大約是 30%。
常見失誤:漏掉 ,得出的是投中和投失某一種特定次序的概率,而不是全部次序;把指數調轉成 ,算出來的是投失 球而不是成功 次的概率。
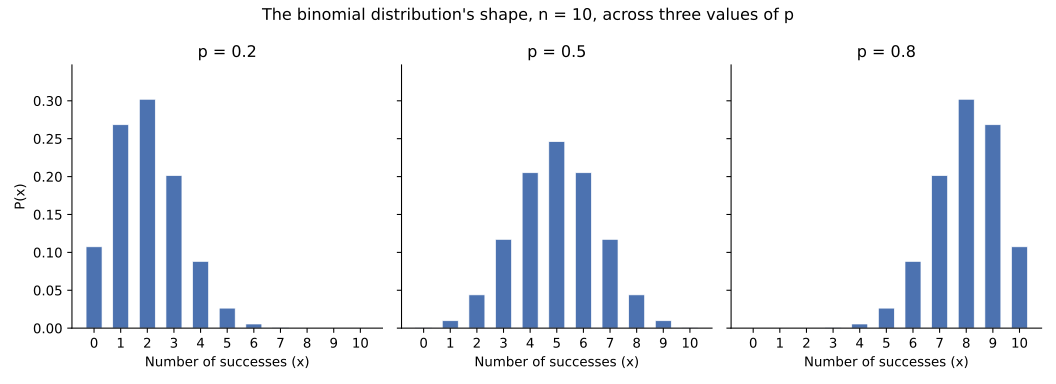
「任何『若干次嘗試中的成功次數』都算是二項的。」 各次嘗試會互相影響的話就不算:不放回地抽 8 張牌來點算紅色的牌,每一次抽牌都改變概率,破壞了獨立性;那裡適用的是另一種分佈。「『至少』可以用計算剛好那個數目的概率來回答。」 「至少投中 6 球」問的是一個範圍: 和 合在一起,而不是單獨的 一個值。
二項隨機變量的平均數與標準差
二項隨機變量的和可以簡化為 和 ,不需要完整的概率分佈表。
平均數: 乘以 ;標準差: 乘以 再乘以 ,然後開平方根。兩者對任何有效的 都成立,不只是 。
對那位罰球球員來說,,,:預期投中 球; 球。
「簡便公式 只在 時才適用。」 它對每一個有效的 都成立; 只是最容易用手驗算的情況,因為在那裡成功和失敗的可能性相等。「 一定是整數,對應一個實際可能的計數。」 這裡 ,在一場比賽的 8 次罰球中她永遠不可能剛好投中這個數;那個「平均數不需要是可以達到的值」的事實,同樣適用於這條簡便公式。
一次看到整個分佈綜合運用
最後一個假設的例子:一個客戶服務中心,每一個來電都以 0.6 的概率獨立地一次過解決,一位主管記錄每 5 個來電中一次過解決的數目。
這個計數是一個:附在一個尚未觀察到的結果上的數,取 0 至 5 這些可以列出的值。寫出它的,就是把這六個值各自配上一個概率,而只有當每一項都介乎 0 與 1 之間、六項加起來剛好等於 1 時才有效。每一次試驗都獨立,有相同的兩個結果和相同的固定概率,所以這個計數也是二項的,,它的和都化為只含 和 的簡短算式。
描述的是很多組五通來電的長遠平均,不是對這一組的保證; 描述的是典型的一組偏離這個平均多遠。兩個數都不承諾接下來會發生什麼;合起來,它們描述了多次重複之下傾向發生什麼的形狀,一次以表的形式呈現,一次以公式的形式呈現。
資料來源
- 1 OpenStax Introductory Statistics §4.1: Probability Distribution Function (PDF) for a Discrete Random Variable — 來源
- 2 OpenStax Introductory Statistics §4.2: Mean or Expected Value and Standard Deviation — 來源
- 3 OpenStax Introductory Statistics §4.3: Binomial Distribution — 來源
- 4 NIST/SEMATECH e-Handbook of Statistical Methods §1.3.6.6.18: Binomial Distribution (states the closed-form PMF and the mean np, SD √(np(1−p))) — 來源