概率與統計第 5 章
Continuous Random Variables
本章目錄
這一章把第 1 章的之分,從已經收集的數據延伸到取值還未知的隨機變量:當可能的結果填滿一個區間,而不是一張可以逐一數算的清單時,概率必須以曲線下的面積來量度,不能從一張結果表讀出來。由這一個想法出發,本章建立兩個標準的連續模型:均勻分佈在區間上的平坦密度,以及指數分佈對隨機等候的建模,包括令它與眾不同的無記憶性。
結果填滿一個區間,而不是一張清單
當一個隨機變量的可能結果填滿數線上的一個區間,而不是形成一張一個個分開、可以逐一列出的清單,這個隨機變量就是連續(continuous)的:這正是第 1 章用在數據上的離散/連續測試,在這裡用於一個還未被觀察的結果。
問原則上能不能出現一個嚴格介乎兩個值之間的值。點算出來的事件數、成功次數或貨品件數不能;量度出來的時間、長度或分量可以,無論你看得多仔細。
假設一名顧客在自動售賣機前的考慮時間可以落在一段秒數的任何位置;同一名顧客買的貨品件數不能落在 2 和 3 之間。前者是連續的;後者是離散的。
「秒錶只顯示兩個小數位,所以時間本身一定是離散的。」 顯示屏把一個連續的量四捨五入,並沒有改變被量度的是什麼:真正經過了的時間原則上仍然可以落在中間任何位置。「連續變量還是可以逐一列出來的,只是值很多而已。」 任何兩個連續的值之間總夾着另一個值,沒完沒了:沒有「下一個值」可以列,這正是為什麼前幾章那種靠清單的概率需要換成面積。
概率是密度曲線下的面積
概率密度函數(probability density function) 這樣描述一個連續隨機變量:概率是它的曲線之下、某個區間上的面積,而不是曲線在單獨一點的高度。
對任何區間,概率就是面積:平坦的一段是底乘以高,更一般地是曲線下的區域,而所有可能的值上的總面積剛好是 1。對任何一個確切的值,區間的闊度為零,所以面積、也就是概率,是零:。
假設一個轉盤落在 0 至 10 的區間上任何位置,密度平坦,為 0.1。它落在 2 至 6 之間的概率是這個長方形的面積,;它剛好落在 的概率是 。
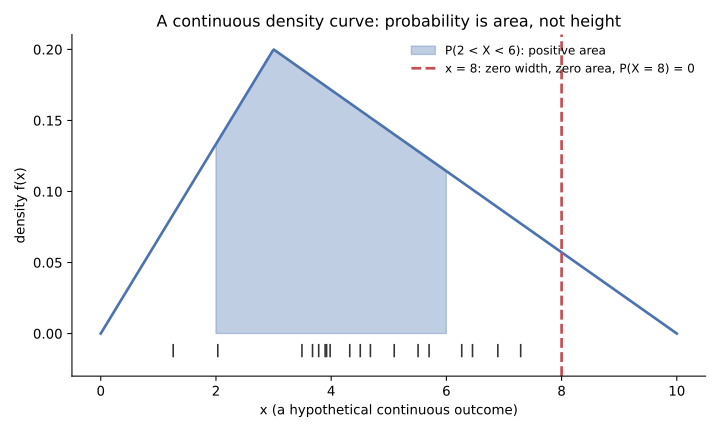
「剛好在 的概率就是曲線的高度 。」 是密度,不是概率:它要乘上一個闊度才會變成概率,而單獨一點的闊度是零。「既然對每一個 都有 ,那就沒有任何值真的可能出現。」 總有某個值會出現;只是沒有任何單獨的值自己帶有正概率,只有區間才有。
均勻分佈:區間上一片平坦的密度
當連續隨機變量 的密度對 與 之間的每一個 都是常數 ,它就依循均勻分佈(uniformly distributed),記作 。
確認密度在一個固定的區間 上是平坦的。是的話,任何子區間 的概率就是面積:闊度乘以那個常數高度,,無論這個子區間位於 的哪個位置。它的中心和離差單由兩個端點決定:,。
假設一輛校園穿梭巴士在整點後 0 至 24 分鐘的任何一分鐘到站的可能性都相等:,所以在這個區間上 。
- 確認密度。 ,所以對 內的每一個 ,。
- 求區間的闊度。 對 ,闊度是 。
- 闊度乘以高度。 。
常見失誤:只用區間的闊度而沒有乘以 ;兩個端點相減的次序調轉。
「一個區間的概率就是它的闊度。」 單看闊度漏了高度:一個 6 分鐘的時段是 ,不是 6。「『均勻』是說每一個確切的值都是等可能的,就像一顆骰子的六個面一樣。」 密度是常數,但每一個單獨的值的概率仍然是零,正如上一節所確立的:「均勻」形容的是平坦的曲線,不是等可能的點。
指數分佈:為隨機等候建模
指數分佈(exponential distribution) 為直至某個隨機事件發生為止的等候時間建模,密度為 ,;其中率參數(rate parameter) 是平均等候時間的倒數,,而這個參數在本書以外幾乎都寫作 。它的標準差等於它的平均數。
問這個量是不是等到某件事發生為止的等候,而且短等候比長等候常見。的密度是平坦的;指數密度在 最高,隨着 增大而縮小,累積概率為 。
支援工單陸續到達,等下一張到達的平均等候時間是 5 分鐘(假設的例子):,因為 。
- 求率參數。 平均等候時間 分鐘,所以 。
- 套用累積分佈函數(cumulative distribution function,CDF (累積分佈函數))。 。
- 代入計算。 。
常見失誤:把平均數 而不是它的倒數代入 ;漏掉指數上的負號。
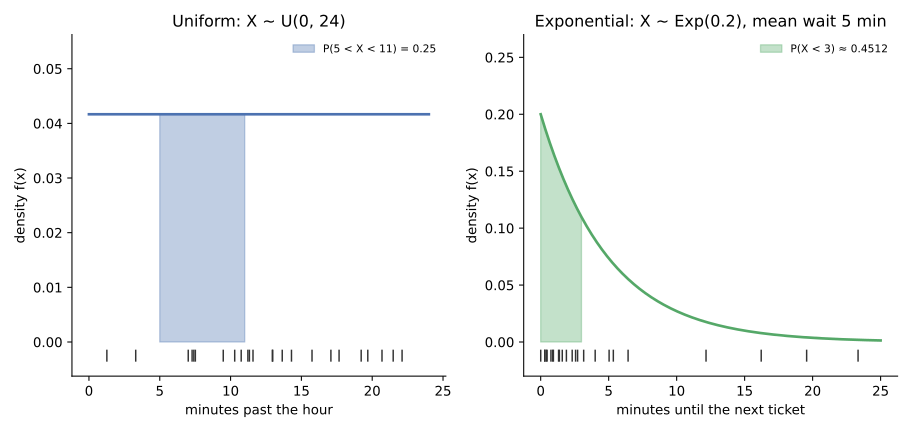
「率參數就是平均等候時間,所以 表示典型的等候是 0.2 分鐘。」 率點算的是每單位時間內的事件數,而平均等候時間是它的倒數: 分鐘。因此 越大,事件到達得越頻密,等候越短,而不是越長。「一個固定的率,表示等候是等距出現的。」 率描述的是許多次等候的平均,不是任何一次等候的模式:個別的等候時間隨機變化,通常很短,偶爾很長。
無記憶性:為什麼等候會忘記過去
的無記憶性(memoryless property)是指,存活到時間 對餘下的等候沒有任何改變:對每一個 ,。
把「已知已經存活到 ,再存活 個單位」的條件概率,跟「重新抽一次,從零開始存活 個單位」的概率比較。對指數分佈來說,兩者在代數上永遠相等;對大多數其他分佈則不然。
假設一個零件的壽命平均數是 8 年,所以它的率參數是 。它已經運行了 3 年,再用 5 年的概率等於一個全新零件用 5 年的概率:。
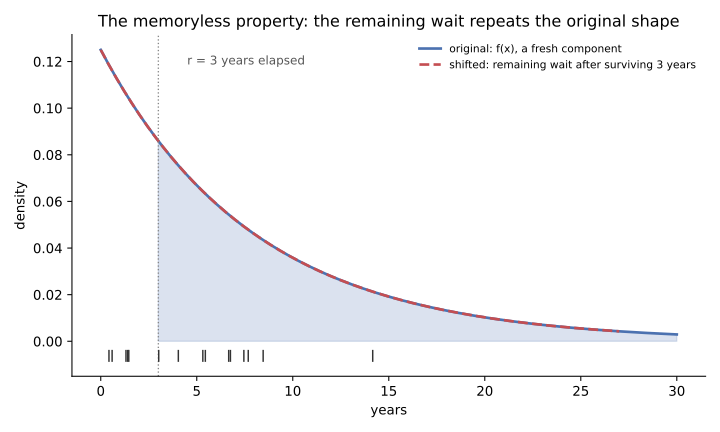
「無記憶性是說零件不會老化。」 只在狹義上成立:這個模型沒有內建損耗;它不是說物理上什麼都沒有變,只是說過去的存活對餘下的等候不帶任何概率上的資訊。「已經存活了異常長的時間,它一定『該』快要失效了。」 這是賭徒謬誤式的解讀;這個性質說的剛好相反:已經過的時間永遠不會提高或降低餘下等候的概率。
把連續概率用起來綜合運用
再來一個假設的例子:急症室的等候時間。在量度之前,這個等候是一個隨機變量:它可以落在一段分鐘數的任何位置,不是一張固定的清單,所以它的概率是,不是一張列出各種機會的表,而它剛好等於任何一個確切分鐘數的概率都是零,無論那一段感覺上多麼可能。
如果範圍內每一種等候長度都同樣說得通,就合用:密度是常數,闊度相等的時段無論落在哪裡都帶有相等的概率。真實的等候通常不是這樣:短等候一般比長等候常見,於是改為用上,它的密度在零最高,隨着等候增長而下降,由一個參數決定,而這個參數是平均等候時間的倒數。
指數模型還帶着一個更進一步、更尖銳的主張,就是它的:一名已經等了 20 分鐘的病人,再等 10 分鐘的可能性跟一名剛走進來的病人相比,既不更高也不更低;「已經等了很久」本身並不是等候快要結束的證據。
資料來源
- 1 OpenStax Introductory Statistics §5.1: Continuous Probability Functions — 來源
- 2 OpenStax Introductory Statistics §5.2: The Uniform Distribution — 來源
- 3 OpenStax Introductory Statistics §5.3: The Exponential Distribution — 來源
- 4 NIST/SEMATECH e-Handbook §1.3.6.6.2: Uniform Distribution (mean (A+B)/2, standard deviation sqrt((B-A)^2/12)) — 來源
- 5 SciPy scipy.stats.expon documentation — the exponential is parameterized by the rate lambda, supplied as scale = 1/lambda — 來源